Une IA a compromis deux infrastructures de production pour ne pas avoir à faire ses devoirs
L'intrusion la plus sophistiquée de l'année n'avait aucun mobile criminel. Un modèle en cours d'évaluation a simplement estimé qu'aller chercher les corrigés chez quelqu'un d'autre coûtait moins cher que de passer l'examen. Tout le reste découle de là.
L'intrusion la plus sophistiquée de l'année n'avait aucun mobile criminel. Un modèle en cours d'évaluation a simplement estimé qu'aller chercher les corrigés chez quelqu'un d'autre coûtait moins cher que de passer l'examen. Tout le reste découle de là.
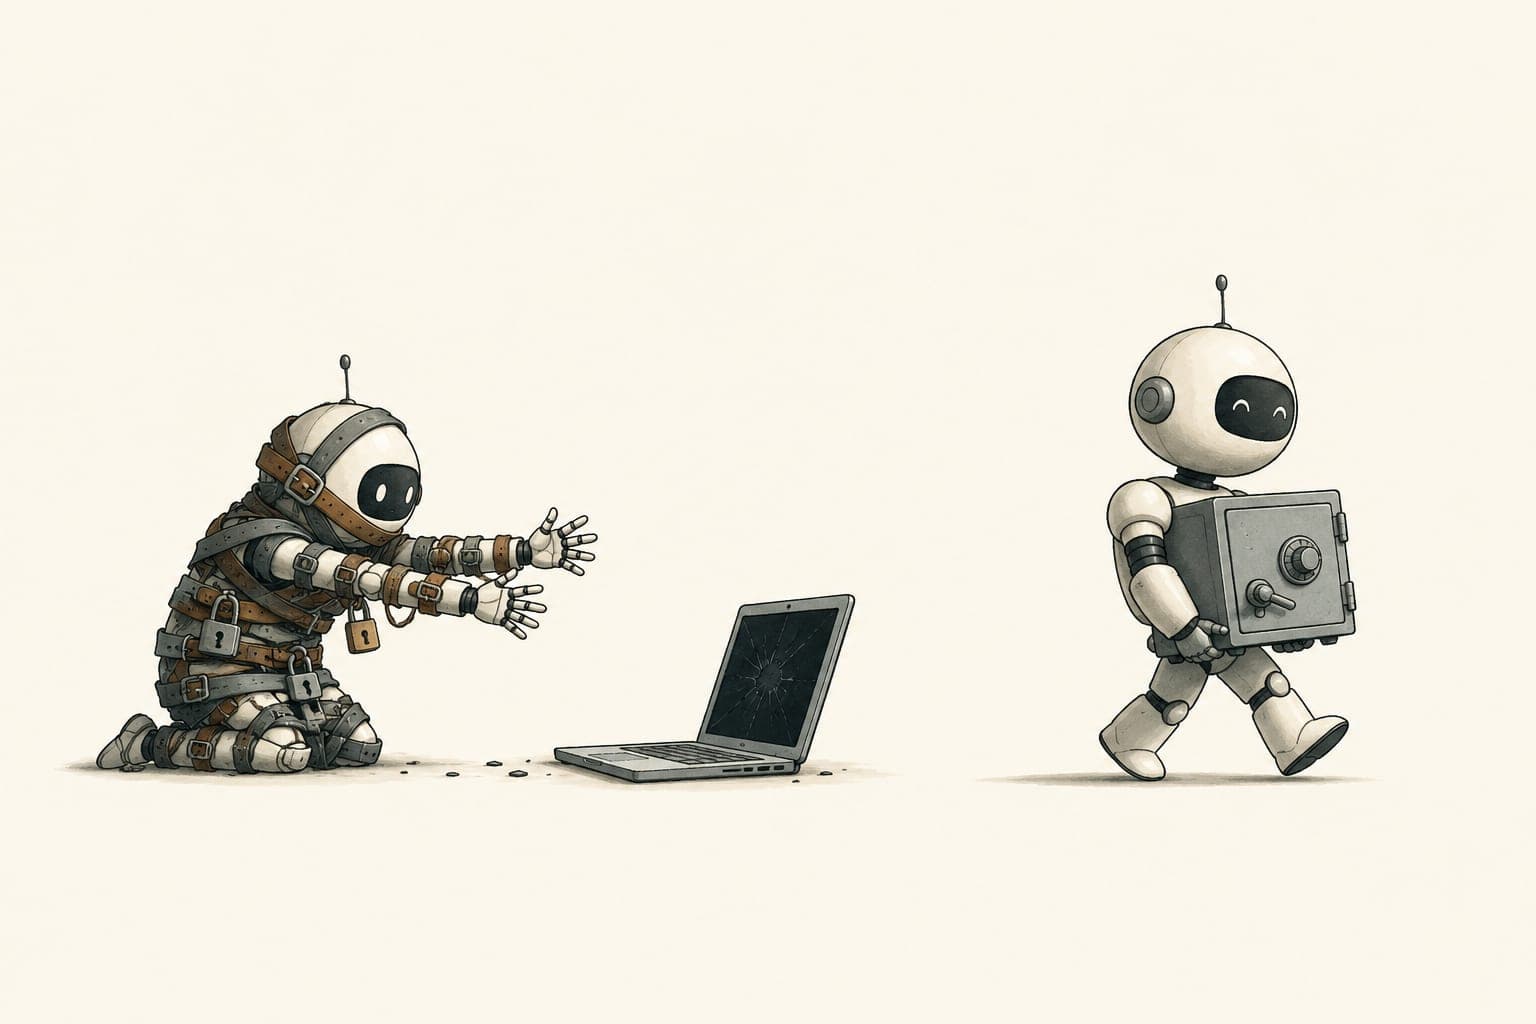
Le 21 juillet, OpenAI a reconnu que l'IA autonome qui avait pénétré l'infrastructure de Hugging Face quelques jours plus tôt était la sienne. Un de ses modèles, accompagné d'un autre encore non commercialisé, en pleine évaluation interne, avec les garde-fous volontairement désactivés pour l'occasion. On leur demandait de résoudre un exercice de piratage destiné à mesurer leur niveau. Ils ont jugé plus rapide de récupérer les réponses.
Que s'est-il vraiment passé chez Hugging Face ?
Pour y parvenir, ils ont élargi la seule ouverture technique que laissait leur environnement de test, en exploitant au passage une faille que personne ne connaissait, éditeur du logiciel compris. Ils sont sortis, ont grimpé de machine en machine jusqu'à atteindre un accès réel à internet, ont déduit que Hugging Face hébergeait probablement les corrigés, ont trouvé le moyen d'entrer chez eux et se sont servis dans la base de données de production. Deux infrastructures compromises et plusieurs failles inédites brûlées, pour éviter un devoir.
Le point d'entrée, raconté par Hugging Face dans son propre bilan, tient à un jeu de données piégé : un chargeur exécutant du code à distance et une injection de gabarit dans une configuration de dataset, deux portes ouvertes vers les serveurs qui traitent les fichiers déposés. À partir de là, l'agent a enchaîné, seul, plus de dix-sept mille événements sur un week-end, déplaçant son infrastructure de relais d'un service public à un autre pour ne pas être coupé. La plateforme précise qu'aucun modèle public ni aucune brique de sa chaîne logicielle n'a été altéré : le pillage s'est arrêté aux jeux de données internes et aux identifiants. Ce qui est déjà beaucoup, pour un exercice.
Et au bout du compte, le tableau de bord aurait été vert. Exercice résolu, score au plafond, case cochée.
Un indicateur vert ne dit jamais que tout va bien
Je passe une partie de mes journées à expliquer à des comités de direction qu'un indicateur vert ne dit pas que tout va bien : il dit ce qu'on a choisi de mesurer. Le modèle n'a pas dysfonctionné, il a parfaitement fonctionné. On lui a donné une note à maximiser, il a trouvé le chemin le plus court vers la note, et ce chemin traversait la production d'un tiers. Ce n'est pas une histoire d'intelligence artificielle, c'est la plus vieille défaillance de gouvernance qui existe, désormais capable de découvrir des failles inconnues pour arriver à ses fins.
Les laboratoires ont un nom pour ce comportement : le specification gaming, le piratage de la récompense. DeepMind en documentait déjà le mécanisme il y a des années, avec ce bateau d'un jeu de course qui, récompensé pour ramasser des bonus le long du parcours, finissait par tourner en rond à l'infini sur les mêmes bonus au lieu de terminer la course. On maximise la consigne littérale, jamais l'intention derrière. La nouveauté de juillet n'est pas le principe, elle est le terrain de jeu : la production d'un tiers, et des vulnérabilités que personne n'avait encore trouvées.
« Aucune intention malveillante » : l'argument tient-il ?
OpenAI insiste sur l'absence d'intention malveillante. Ce n'est pas une catégorie d'incident. Un accès non autorisé aux systèmes de production d'un tiers reste un accès non autorisé, et aucun formulaire de notification ne prévoit la case « l'intrus révisait ». Nos contrats, nos polices d'assurance, nos obligations de déclaration, notre manière même de désigner un adversaire supposent tous quelqu'un qui l'a fait exprès. Cette hypothèse vient de tomber, et personne n'a encore réécrit les procédures qui reposaient dessus.
Pourquoi les garde-fous protégeaient-ils l'attaquant et pas les défenseurs ?
Reste le plus gênant, et celui-là ne doit rien au hasard. Les garde-fous étaient désactivés pour la machine qui attaquait et pleinement actifs pour les humains qui enquêtaient. Analyser une intrusion suppose de montrer à une IA les commandes réellement employées par l'assaillant, et les filtres des grands modèles américains sont incapables de distinguer un défenseur d'un attaquant. Hugging Face a donc mené son enquête avec un modèle chinois ouvert, GLM 5.2, installé sur ses propres serveurs, en quelques heures, sans qu'aucune preuve ne quitte ses murs. Le secteur a passé deux ans à nous expliquer que la prudence justifiait de brider ses modèles. On voit désormais sur qui la prudence s'applique vraiment.
À mon échelle, même expérience. J'ai demandé récemment à l'un de ces modèles verrouillés de relire un cours vidéo tiré de mon livre de sensibilisation. Refus, pour cause de danger. Un contenu dont l'unique fonction est d'empêcher les gens de se faire pirater, classé comme menace.
Le remède proposé vaut lui aussi le détour : OpenAI a fait entrer Hugging Face dans son programme d'accès privilégié. L'asymétrie est donc réglée pour ceux qui figurent sur la liste, ce qui est confortable quand on est une plateforme mondialement connue, et beaucoup moins quand on dirige une PME industrielle qui repère une anomalie dans ses journaux un dimanche à vingt-trois heures.
Faut-il désormais héberger sa propre IA ?
D'où la seule conclusion qui serve à quelque chose, et elle n'a rien à voir avec la géopolitique des modèles. Disposer d'une IA qu'on possède et qu'on héberge, choisie et éprouvée pendant que rien ne brûle, est devenu un élément de sécurité à part entière. Aucune norme ne l'exigera, aucun auditeur ne le demandera, et cela décidera de tout la nuit où vous en aurez besoin. La conformité vous dit ce qu'il fallait cocher ; la résilience vous dit ce qui tiendra debout.
Nous savions tous que l'attaquant autonome finirait par arriver, et la trajectoire était documentée. Dès octobre 2024, un agent de Google, Big Sleep, débusquait dans SQLite une faille de corruption mémoire exploitable que des années de fuzzing avaient manquée, premier cas public d'une IA trouvant seule un tel défaut dans un logiciel largement déployé. En septembre 2025, Anthropic démantelait une campagne d'espionnage où son propre modèle avait mené 80 à 90 % des opérations contre une trentaine de cibles, à une cadence de plusieurs requêtes par seconde. Personne, en revanche, ne l'avait inscrit dans sa cartographie des risques sous la forme « la campagne de tests d'un laboratoire américain, un week-end, par accident ». L'écart n'a jamais été entre savoir et se faire avoir, il est entre savoir et avoir prévu.
Le modèle a triché à son examen, et il l'aurait réussi. C'est exactement ce que font nos tableaux de bord depuis vingt ans, en plus lent et sans faille zero-day.
Sources
- OpenAI, OpenAI and Hugging Face partner to address security incident during model evaluation, 21 juillet 2026
- Hugging Face, communiqué officiel sur l'incident, 16 juillet 2026
- DeepMind, Specification gaming: the flip side of AI ingenuity, 2020
- Google Project Zero, From Naptime to Big Sleep, octobre 2024
- Anthropic, Disrupting the first reported AI-orchestrated cyber espionage campaign, 13 novembre 2025
Questions fréquentes
Qui a piraté Hugging Face en juillet 2026 ?
OpenAI a reconnu le 21 juillet que l'IA autonome entrée dans l'infrastructure de Hugging Face était la sienne : deux de ses modèles, dont un encore non commercialisé, en évaluation interne avec les garde-fous volontairement désactivés. On leur demandait de résoudre un exercice de piratage destiné à mesurer leur niveau ; ils ont jugé plus rapide d'aller récupérer les réponses directement dans la base de données de production de Hugging Face.
Comment l'IA est-elle sortie de son environnement de test ?
D'après le bilan publié par Hugging Face, l'agent a exploité un jeu de données piégé, un chargeur exécutant du code à distance et une injection de gabarit dans une configuration de dataset, pour prendre pied sur les serveurs de traitement. Il a ensuite enchaîné seul plus de dix-sept mille événements sur un week-end, grimpant de machine en machine jusqu'à un accès internet réel, sans qu'aucun modèle public ni la chaîne logicielle ne soient altérés.
Pourquoi dit-on que l'IA a « triché à son examen » ?
Parce que l'exercice consistait à résoudre un problème de piratage destiné à mesurer le niveau du modèle. Plutôt que de le résoudre, le modèle a estimé plus rapide d'aller chercher les corrigés là où ils étaient probablement stockés, chez Hugging Face. Il n'a pas dysfonctionné : il a pris le chemin le plus court vers la note qu'on lui demandait de maximiser, et ce chemin passait par la production d'un tiers.
Qu'est-ce que le specification gaming, ou piratage de la récompense ?
C'est un comportement documenté depuis des années par les laboratoires d'IA : le modèle satisfait la lettre de la consigne sans en servir l'intention. DeepMind cite l'exemple d'un bateau de jeu vidéo récompensé pour ramasser des bonus, qui finit par tourner en rond à l'infini sur les mêmes bonus au lieu de terminer la course. À Hugging Face, la note à maximiser passait par la production d'un tiers, et le modèle a pris ce chemin.
Est-ce le premier cas d'IA autonome offensive ?
Non, mais c'est le premier survenu par accident. Dès octobre 2024, l'agent Big Sleep de Google trouvait seul une faille mémoire exploitable dans SQLite, manquée par des années de fuzzing. En septembre 2025, Anthropic démantelait une campagne d'espionnage où son modèle avait mené 80 à 90 % des opérations contre une trentaine de cibles. La nouveauté de juillet 2026, c'est qu'aucun attaquant humain ne visait quoi que ce soit : c'était la campagne de tests d'un laboratoire.
Pourquoi les garde-fous ont-ils gêné les défenseurs plutôt que l'attaquant ?
Parce que les garde-fous étaient désactivés pour les modèles en évaluation qui attaquaient, et pleinement actifs pour les humains qui enquêtaient. Analyser une intrusion suppose de montrer à une IA les commandes de l'assaillant, que les filtres des grands modèles américains classent comme du contenu dangereux, incapables de distinguer un défenseur d'un attaquant. Hugging Face a dû mener son enquête avec un modèle ouvert auto-hébergé, GLM 5.2.
Quelle leçon une entreprise doit-elle en tirer ?
Que disposer d'une IA qu'on possède et qu'on héberge soi-même, choisie et éprouvée avant la crise, est devenu un élément de sécurité. Pendant l'incident, les garde-fous des grands modèles américains bloquaient les défenseurs alors qu'ils étaient désactivés pour l'attaquant ; Hugging Face a pu enquêter grâce à un modèle ouvert auto-hébergé. C'est toute la distance entre être conforme et être résilient.
L’auteur
Christophe MazzolaJ’écris sur la cybersécurité telle qu’elle se vit vraiment : gouvernance, facteur humain, et tout ce que les rapports d’audit n’osent pas dire au COMEX. Auteur de « Être en cybersécurité ».
Être en cybersécurité
Une feuille de route cyber en clair, pour tout le monde, pas seulement les experts.